Funktionsweise von Suchmaschinen: der Ratgeber
Suchmaschinen helfen dabei, Informationen zu finden. Sie entdecken URLs, rufen Inhalte bei Bedarf ab, prüfen sie für eine mögliche Indexierung und wählen bei einer Suchanfrage passende Ergebnisse aus. Diese Schritte greifen ineinander, sind aber nicht gleichzusetzen.
Wer versteht, an welcher Stufe eine Seite hängen bleibt, kann gezielt eingreifen. Genau das ist die Grundlage des technischen SEO: Crawling ermöglichen, Indexierung nicht behindern, Auslieferung verdienen.
Wie funktioniert eine Suchmaschine?
Eine Suchmaschine verarbeitet Informationen in mehreren Stufen. Zuerst wird eine URL entdeckt. Danach kann ein Crawler ihren Inhalt abrufen und rendern. Anschliessend prüft die Suchmaschine den Inhalt für eine mögliche Indexierung. Erst bei einer konkreten Suchanfrage entscheidet sie, welche indexierten Seiten für diesen Kontext ausgeliefert werden.
Jede Stufe hat eigene Voraussetzungen und kann ausbleiben. Nicht jede bekannte URL wird gecrawlt. Ein erfolgreicher Abruf garantiert weder die Indexierung noch eine sichtbare Platzierung in den Suchergebnissen. Google sagt das ausdrücklich: Es gibt keine Garantie, dass eine Seite gecrawlt, indexiert oder ausgeliefert wird, auch wenn sie alle Richtlinien erfüllt. Und Google nimmt kein Geld dafür, eine Seite häufiger zu crawlen oder höher zu platzieren.
Die drei Stufen im Einzelnen
URL-Entdeckung und Crawling
Suchmaschinen entdecken URLs unter anderem über Links und Sitemaps. Nach der Entdeckung entscheidet ein Crawler algorithmisch, welche URLs er wann abruft. Googlebot passt sein Tempo an die Antworten des Servers an; Fehler wie HTTP 500 bremsen ihn. Das Crawling ist nicht mit der Indexierung gleichzusetzen: Eine URL kann bekannt sein, ohne abgerufen zu werden, und eine abgerufene Seite kann später trotzdem von der Indexierung ausgeschlossen werden.
Rendering und mögliche Indexierung
Beim Abruf rendert Google die Seite mit einer aktuellen Chrome-Version und führt JavaScript aus, damit auch nachgeladene Inhalte sichtbar werden. Danach prüft die Suchmaschine, ob der Inhalt für eine Indexierung in Frage kommt, und bestimmt bei ähnlichen Seiten die kanonische Version. Ein Index ist eine strukturierte Datenbasis, die bei späteren Suchanfragen durchsucht werden kann. Auch eine indexierte Seite wird nicht automatisch für jede Suchanfrage ausgeliefert.
Auslieferung von Suchergebnissen
Bei einer Suchanfrage bewertet Google passende indexierte Seiten im jeweiligen Kontext. Relevanz und Qualität hängen nicht von einer festen, vollständigen Faktorformel ab. Kontextsignale wie Sprache, Standort und Gerät können die Auslieferung beeinflussen. Die blosse Verwendung eines Suchbegriffs oder Popularität garantiert keine Position.
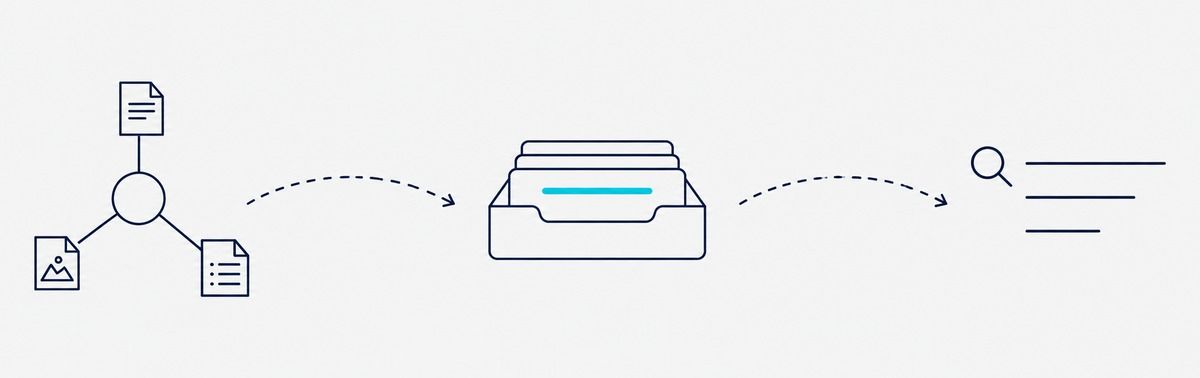
Seiten entdecken
In den Index aufnehmen
Ergebnis ausliefern
Steuerungsgrenzen für Website-Betreiber
Website-Betreiber können Hinweise und technische Signale bereitstellen. Diese Instrumente steuern jedoch unterschiedliche Stufen und ersetzen keinen Zugangsschutz.
robots.txt
Eine robots.txt kann Crawler vom Abruf bestimmter URLs abhalten. Sie ist kein zuverlässiges Mittel, um eine URL aus dem Index auszuschliessen, und kein Schutz für sensible Inhalte. Für nicht öffentliche Inhalte braucht es Zugriffsschutz.
noindex
noindex ist eine Anweisung für die Indexierung, keine Zugangskontrolle. Google kann eine crawlfähige Seite mit noindex aus der Indexierung ausschliessen. Der Einsatz garantiert jedoch weder Crawling, Indexierung noch Auslieferung einer URL.
Canonical
Bei ähnlichen Seiten gruppiert Google mögliche Varianten und wählt eine kanonische URL aus. Ein rel="canonical" ist ein wichtiges Signal für die bevorzugte Version, aber keine verbindliche Anweisung und keine Zusage, dass genau diese URL gewählt wird.
Diagnose und Monitoring
Die Google Search Console unterstützt bei Diagnose und Monitoring, zum Beispiel mit Berichten, URL-Prüfung und Sitemap-Übermittlung. Diese Funktionen helfen bei der Beurteilung von Entdeckung und Indexierungsstatus, erzwingen aber weder Crawling noch Indexierung noch Ranking.
Meldet die Search Console eine Seite als indexiert, die trotzdem nicht in den Ergebnissen erscheint, nennt Google drei typische Gründe: Der Inhalt passt nicht zu den Suchanfragen, die Qualität ist zu tief, oder Robots-Meta-Regeln verhindern die Auslieferung.
Rankingsysteme statt Faktorenliste
Google veröffentlicht keine Liste gewichteter Rankingfaktoren. Stattdessen beschreibt Google in seinem Leitfaden zu den Rankingsystemen, welche automatisierten Systeme zusammenwirken. Sie arbeiten auf Seitenebene, ergänzt um Signale für die ganze Website. Fünf Gruppen prägen das Ergebnis.
Bedeutung verstehen
Systeme wie BERT, RankBrain, Neural Matching und Passage Ranking helfen Google zu verstehen, was eine Suchanfrage meint und welche Seite oder welcher Abschnitt dazu passt, auch ohne dass jedes Wort exakt vorkommt.
Qualität und Verlässlichkeit
Mehrere Systeme heben hilfreiche, originale und verlässliche Inhalte hervor und stufen dünne oder kopierte Inhalte zurück. Das frühere «Helpful Content System» ist seit 2024 Teil der Kernsysteme.
Links und PageRank
Linkanalyse-Systeme, darunter PageRank, werten aus, wie Seiten aufeinander verweisen, um zu verstehen, worum es geht und welche Seiten hilfreich sein könnten. PageRank hat sich seit dem Start stark weiterentwickelt und bleibt Teil der Kernsysteme.
Kontext und Aktualität
Standort, Sprache und Gerät beeinflussen die Ergebnisse. Freshness-Systeme zeigen bei passenden Anfragen neuere Inhalte, ein Site-Diversity-System begrenzt die Treffer einer einzelnen Website, Deduplication blendet Doppeltes aus.
Spam-Erkennung
Systeme wie SpamBrain erkennen Inhalte und Verhalten, die gegen die Spam-Richtlinien verstossen. Die früheren Updates Panda und Penguin sind längst in die Kernsysteme übergegangen.
Bleibt deine Seite in einer der drei Stufen hängen?
Wir prüfen Crawling, Indexierung und Auslieferung deiner wichtigsten Seiten und zeigen dir, wo es klemmt.
Was das für deine Website bedeutet
Aus den drei Stufen folgt eine klare Reihenfolge für die Arbeit an einer Website: Zuerst muss Google die Seiten finden und abrufen können, dann muss der Inhalt eindeutig, hochwertig und nicht durch Anweisungen blockiert sein, und erst dann kann die Auslieferung für die geplanten Suchanfragen überhaupt stattfinden. Welche Fragen eine Seite beantworten soll, gehört trotzdem schon in die Inhaltsplanung.
Fehler in einer frühen Stufe machen Arbeit in einer späteren wirkungslos. Deshalb beginnt jede Analyse bei der Entdeckung und beim Crawling, nicht beim Ranking. Wie das in eine übergreifende SEO-Strategie passt und welche Rolle die Suchmaschinenoptimierung als Ganzes spielt, zeigen unsere Übersichtsseiten.
Häufige Fragen zur Funktionsweise
Was ist der Unterschied zwischen Crawling und Indexierung?
Crawling ist der Abruf einer Seite durch den Googlebot. Indexierung ist die Entscheidung, den analysierten Inhalt in den Index aufzunehmen. Eine gecrawlte Seite kann trotzdem von der Indexierung ausgeschlossen werden.
Warum wird meine Seite nicht indexiert?
Häufige Gründe laut Google: geringe Inhaltsqualität, Robots-Meta-Regeln, die die Indexierung untersagen, oder ein Seitenaufbau, der die Indexierung erschwert. Die Search Console zeigt den Status je URL.
Verhindert robots.txt, dass eine Seite bei Google erscheint?
Nein. robots.txt hält den Crawler vom Abruf ab, nicht die URL aus dem Index. Eine gesperrte URL kann weiterhin erscheinen, dann ohne Beschreibung. Für den Ausschluss braucht es noindex, für sensible Inhalte einen Zugriffsschutz.
Ist rel="canonical" eine Anweisung an Google?
Nein, ein Hinweis. Google gruppiert ähnliche Seiten und wählt selbst die kanonische Version. Der Canonical-Hinweis ist ein starkes Signal dafür, aber keine Garantie.
Gibt es eine Liste der Google-Rankingfaktoren?
Nein. Google beschreibt Rankingsysteme wie BERT, RankBrain, PageRank, Freshness oder SpamBrain, veröffentlicht aber keine gewichtete Faktorenliste. Listen mit «200 Faktoren» stammen nicht von Google.
Kann ich bezahlen, damit Google meine Seite höher platziert?
Nein. Google nimmt kein Geld dafür, eine Seite häufiger zu crawlen oder höher zu platzieren. Bezahlte Anzeigen sind ein getrenntes System und als solche gekennzeichnet.
Weiterlesen zu Crawling, Indexierung und Ranking
Die folgenden Themen schliessen fachlich an diese Seite an:
- Technisches SEO: Crawling, Indexierung und die technische Basis einer auffindbaren Website.
- robots.txt im Glossar: steuern, was Suchmaschinen überhaupt abrufen.
- Canonical-Tag: die bevorzugte Version ähnlicher Inhalte auszeichnen.
- SEO-Pagination: wie paginierte Listen entdeckt und indexiert werden.
- Rich Results und strukturierte Daten: wie Google Inhalte in der Auslieferung erweitert darstellt.
- Suchmaschinenoptimierung im Überblick: wie technische Arbeit, Inhalt und Verlinkung zusammenspielen.
Über die Autorin
Lisa-Marie Unger
Lisa-Marie hat 2018 Publizistik und Kommunikationswissenschaften abgeschlossen und arbeitet bei netpulse AG als Projektleiterin für Google Ads. Sie informiert über SEO (Suchmaschinenoptimierung) und führt Schulungen durch.