Crawling steuern: robots.txt, Sitemaps und Crawl-Budget
Suchmaschinen müssen eine Seite zuerst finden und abrufen, bevor sie ihren Inhalt verarbeiten können. Dieses Crawling lässt sich nicht durch einen einzelnen Schalter optimieren. Entscheidend ist, dass wichtige Seiten über klare Links erreichbar sind, dass technische Hinweise zusammenpassen und dass unnötige URL-Varianten nicht endlos Ressourcen beanspruchen.
Ziel dieses Leitfadens: Du kannst nach dem Lesen unterscheiden, welche URLs Suchmaschinen finden sollen, welche Bereiche nicht gecrawlt werden müssen und wann eine vertiefte Crawl-Budget-Analyse sinnvoll ist. Crawling steuern ist ein Baustein des technischen SEO.
Was Crawling leistet und was nicht
Crawler sind automatisierte Programme, die bekannte URLs abrufen und Links zu weiteren Seiten folgen. Crawler helfen Suchmaschinen, Inhalte zu entdecken. Crawling ist aber nicht dasselbe wie Indexierung: Ein Abruf bedeutet nicht automatisch, dass eine URL im Suchindex erscheint. Ebenso ist Crawling kein Rankingversprechen.
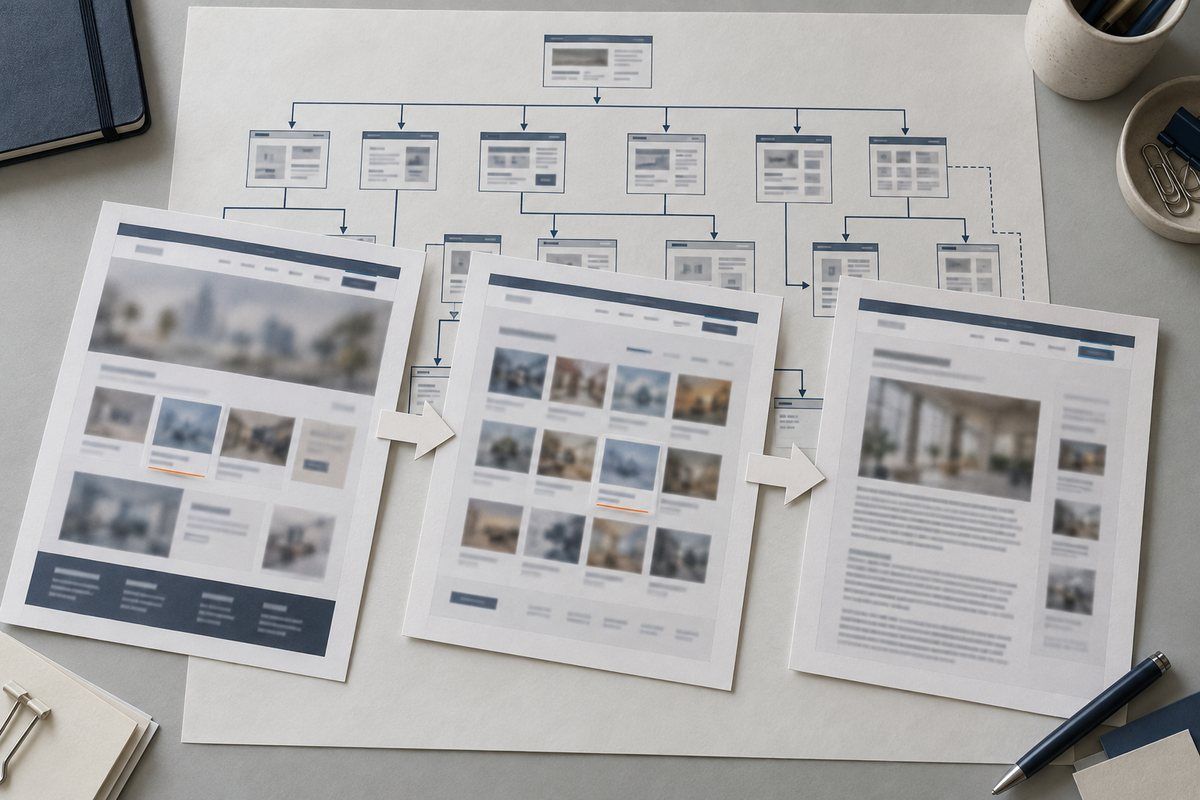
Für die Praxis sind drei Fragen nützlich, die weiter unten je eine eigene Karte haben: der normale Link, die XML-Sitemap und die technischen Signale.
Wichtige Seiten erhalten klare Wege
Wichtige Angebots-, Wissens- oder Kategorieseiten sollten nicht nur über ein tief verschachteltes Menü erreichbar sein. Interne Links zeigen sowohl Nutzern als auch Crawlern, welche Seiten zusammengehören. Crawl-Tiefe beschreibt die Anzahl Linkschritte vom Einstieg zu einer Seite. Eine geringe Tiefe ist kein Selbstzweck, aber wichtige Seiten sollten nicht nur über lange Ketten oder zufällige Filterseiten auffindbar sein.
Praxis-Check: Wähle drei wichtige URLs. Prüfe, von welchen thematisch passenden Seiten sie verlinkt sind, ob der Link normal klickbar ist und ob die Zielseite in einer XML-Sitemap steht, sofern sie indexiert werden soll.
Ist die Seite normal verlinkt?
Prüfe, ob die gewünschte Seite über einen normalen HTML-Link erreichbar ist. Ein Crawler folgt Links zu weiteren Seiten. Navigation und thematisch passende Links im Inhalt ergänzen sich dabei: Wichtig ist, dass wichtige URLs über nachvollziehbare, crawlbare Links zugänglich sind.
Zeigt die Sitemap auf die richtige URL?
Prüfe, ob die XML-Sitemap auf die gewünschte, kanonische URL verweist. Eine Sitemap unterstützt das Auffinden. Die Sitemap ersetzt weder die interne Verlinkung noch eine Entscheidung darüber, welche URL indexiert werden soll.
Passen die technischen Signale zusammen?
Prüfe, ob robots.txt, Canonical, noindex und interne Links nicht gegeneinander stehen. Widersprechen sich diese Signale, entstehen Ergebnisse, die sich weder aus einer einzelnen Einstellung noch aus dem sichtbaren Inhalt erklären lassen.
robots.txt und noindex lösen verschiedene Aufgaben
Die robots.txt regelt für kooperierende Crawler, welche Pfade sie nicht abrufen sollen. Die Datei eignet sich, wenn automatisch erzeugte oder technisch unwichtige URL-Räume gar nicht gecrawlt werden müssen. Eine robots.txt-Regel macht eine URL jedoch nicht zuverlässig unsichtbar, wenn diese über andere Wege bekannt wird.
noindex ist eine Anweisung für die Indexierung. Damit Suchmaschinen sie lesen können, müssen sie die URL in der Regel erst abrufen dürfen. Deshalb ist robots.txt kein Ersatz für noindex und noindex kein Ersatz für eine Crawl-Sperre. Wer beide Signale pauschal auf dieselbe URL setzt, verhindert möglicherweise, dass die noindex-Anweisung überhaupt gelesen wird.
Interne Suche als Sonderfall
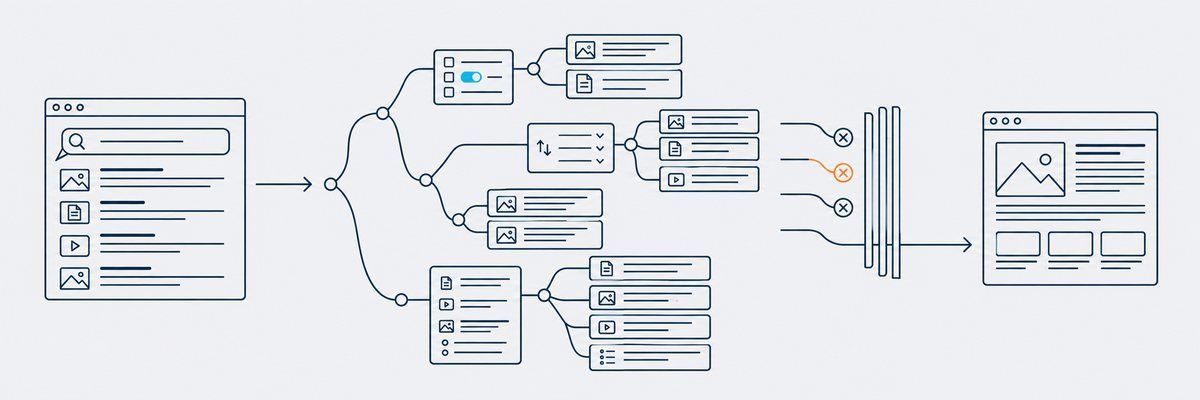
Interne Suchseiten können für jedes eingegebene Wort eine neue URL erzeugen. Werden diese Ergebnisseiten indexierbar oder verlinken sie immer neue Vorschläge, entsteht ein sehr grosser bis praktisch unendlicher Crawl-Raum. Das kann Spam sichtbar machen und Ressourcen binden, ohne Nutzern eigenständigen Suchinhalt zu bieten.
Prüfe zuerst, wie die Suche URLs erzeugt. Prüfe danach in robots.txt und im Indexierungsbericht, ob Suchpfade oder Parameter unerwünscht sichtbar werden. Eine robots.txt-Regel muss alle relevanten Varianten abdecken. Die konkrete Regel hängt vom System und seinen Parametern ab und wird hier bewusst nicht erfunden. Wie ein Suchfeld zum Risiko wird, zeigt der Beitrag zur internen Suche.
Eine Suchanfrage
Wachsender URL-Raum
Passende Steuerung
Sitemaps helfen bei der Entdeckung, ersetzen aber keine Struktur
Eine XML-Sitemap ist eine maschinenlesbare Liste von URLs, die Suchmaschinen beim Auffinden wichtiger Seiten unterstützen kann. Die Sitemap ersetzt keine interne Verlinkung und macht eine problematische oder nicht indexierbare URL nicht automatisch wertvoll. In die Sitemap gehören grundsätzlich die URLs, die als kanonische, indexierbare Zielseiten vorgesehen sind.
Prüfe bei auffälligen Seiten zuerst, ob Sitemap, Canonical, Statuscode und interne Linkziele dieselbe URL meinen. Parameter-, Filter-, Duplikat- oder bewusst ausgeschlossene URLs gehören nicht einfach deshalb in die Sitemap, weil sie technisch existieren.
Crawl-Budget richtig einordnen
Crawl-Budget beschreibt vereinfacht, wie viel Abrufkapazität Suchmaschinen einer Website widmen. Für eine normale, überschaubare KMU-Website ist es selten der erste Engpass. Wichtiger sind klare interne Links, indexierbare Inhalte, saubere URL-Räume und eine technisch erreichbare Website.
Relevant wird das Thema eher bei sehr grossen Websites, häufig veränderten Beständen, Shops, Portalen oder Plattformen mit vielen Parameter- und Filter-URLs. Dort kann es sinnvoll sein, Serverlogs, den Crawling-Bericht und URL-Muster auszuwerten, bevor technische Massnahmen beschlossen werden.
304, ETags und unveränderte Seiten
Wie sich Abrufe schonen lassen und wo dabei ein Fehler entsteht, zeigen die beiden folgenden Fälle. Der Beitrag 304 statt 200 vertieft das Thema.
Sinnvoller Einsatz
HTTP 304 ist die Antwort auf eine bedingte Anfrage. Ein Client sendet dabei einen Validator mit, etwa If-None-Match mit dem bekannten ETag oder If-Modified-Since mit dem bekannten Zeitstempel. Ergibt die Prüfung, dass sich die Ressource nicht geändert hat, kann der Server mit 304 und ohne Antwortinhalt antworten; hat sie sich geändert, folgt die vollständige Antwort. Gespart wird die Übertragung des Inhalts, nicht zwingend die serverseitige Prüfarbeit. Das ist eine technische Effizienzmassnahme, kein Ranking-Hebel und kein Ersatz für das Aufräumen unnötiger URLs.
Falsche Konfiguration
Falsche 304-Antworten sind problematisch: Wenn sich Inhalte geändert haben, der Server aber 304 liefert, können Suchmaschinen die neue Fassung übersehen. Bei mehreren Servern müssen ETags konsistent sein. Ob ein Hosting, CDN oder Baukasten dies zuverlässig erledigt, ist ohne Messung offen.
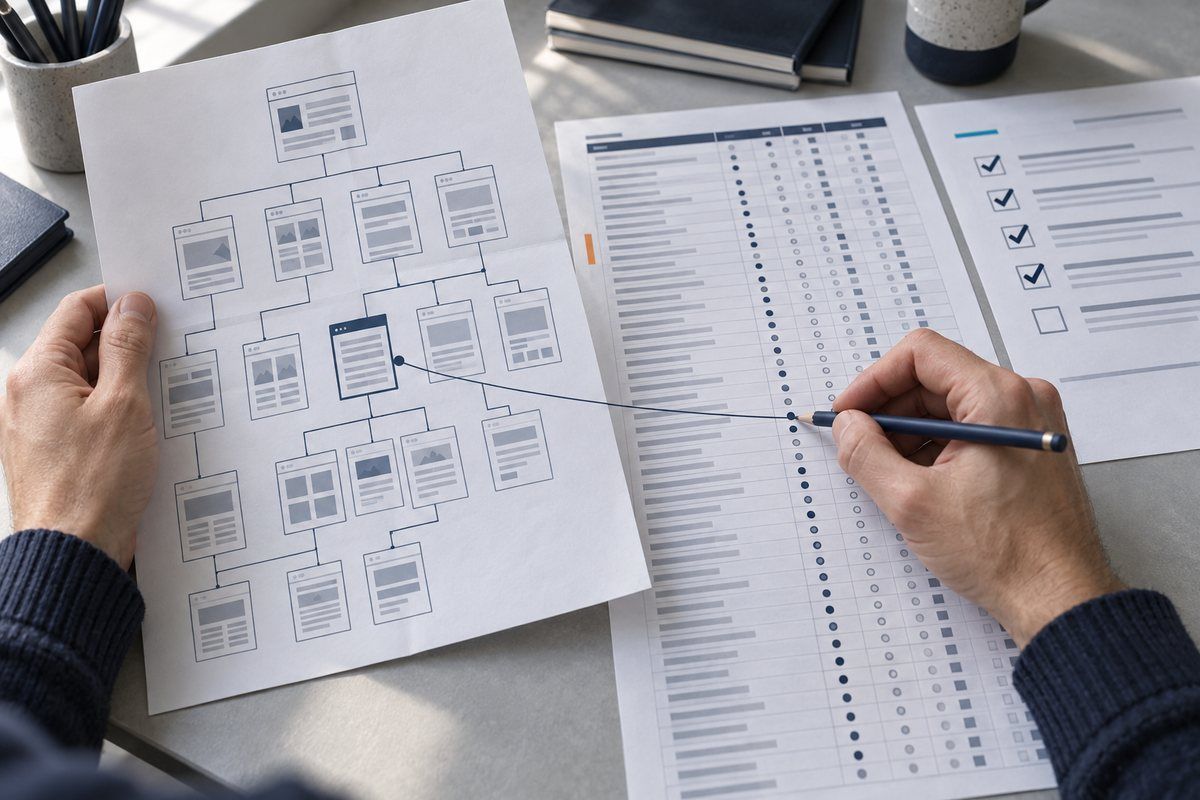
Vor einer Massnahme steht die Aufnahme: betroffene URL, Verlinkung, Canonical, Indexierbarkeit, Statuscode und Sitemap-Eintrag.
Diagnose zuerst, dann gezielt handeln
Wenn wichtige Seiten nicht zuverlässig auftauchen, beginne nicht mit pauschalen Sperren oder Weiterleitungen. Dokumentiere zuerst die betroffene URL, ihre interne Verlinkung, den Canonical, die Indexierbarkeit, den Statuscode und ihren Eintrag in der XML-Sitemap. Prüfe anschliessend, ob das Problem eine einzelne URL, einen URL-Typ oder eine technische Ursache betrifft.
Bei grossen Websites zeigen Serverlogs und der Crawling-Bericht, wohin Abrufe fliessen. Bei kleineren Websites genügt oft ein überschaubarer URL-Check. Eine sinnvolle Reihenfolge in fünf Schritten:
Wichtige Zielseiten definieren
Halte fest, welche Angebots-, Wissens- und Kategorieseiten Suchmaschinen finden sollen. Ohne diese Liste lässt sich nicht beurteilen, ob ein Abruf an der richtigen Stelle landet.
Unerwünschte URL-Räume erkennen
Erfasse automatisch erzeugte Bereiche wie interne Suche, Filter- und Sortiervarianten. Halte fest, welche davon keinen eigenständigen Zweck für Suchende haben.
Interne Linkwege prüfen
Prüfe, von welchen thematisch passenden Seiten eine wichtige URL verlinkt ist und ob dieser Link normal klickbar ist. Lange Ketten und zufällige Filterseiten sind kein verlässlicher Weg.
Technische Signale vergleichen
Stelle robots.txt, Canonical, noindex, Statuscode und Sitemap-Eintrag derselben URL nebeneinander. Erst im Vergleich zeigt sich, ob die Signale dieselbe Absicht tragen.
Eine konkrete Massnahme testen
Ändere gezielt einen Punkt statt mehrerer gleichzeitig, und prüfe danach die Wirkung. Eine Massnahme ohne vorherige Aufnahme lässt sich später weder beurteilen noch zurückbauen.
Unsicher, welche Massnahme zu deinem Fall passt?
netpulse nimmt deine wichtigen URLs, die internen Linkwege und die technischen Signale auf und zeigt dir, welcher Schritt zuerst sinnvoll ist.
Häufige Fragen
Soll ich robots.txt oder noindex verwenden?
Nutze robots.txt, wenn ein URL-Raum nicht gecrawlt werden soll. Nutze noindex, wenn eine abrufbare URL nicht im Index erscheinen soll. Prüfe den konkreten Fall, statt beide Signale reflexartig zu kombinieren.
Muss jede URL in die XML-Sitemap?
Nein. Die Sitemap soll wichtige, kanonische und indexierbare URLs unterstützen. Die Sitemap ersetzt weder die interne Verlinkung noch eine Entscheidung über Duplikate, Filter oder bewusst ausgeschlossene Seiten.
Ist Crawl-Budget für jede Website wichtig?
Nein. Für grosse, dynamische oder sehr URL-reiche Websites kann es wichtig sein. Bei kleinen Websites lösen klare Inhalte, Linkwege und saubere technische Grundlagen häufig dringendere Probleme.
Verbessert Crawling mein Ranking automatisch?
Nein. Gute Auffindbarkeit schafft erst die Voraussetzung, dass Suchmaschinen Inhalte verarbeiten können. Sichtbarkeit hängt zusätzlich von Inhalt, Suchintention, Wettbewerb und weiteren Signalen ab.
Weiterlesen zu Crawling, URL-Räumen und Auffindbarkeit
Die folgenden Themen schliessen fachlich an diese Seite an:
- Technisches SEO : die Übersichtsseite, unter der diese Anleitung steht.
- Crawl-Tiefe : wie viele Linkschritte wichtige Seiten vom Einstieg entfernt sind.
- 304 statt 200 : unveränderte Ressourcen und ihre Wirkung auf Abrufe.
- Interne Suche : wie ein Suchfeld unbegrenzte URL-Räume erzeugt.
- robots.txt , Sitemap und XML-Sitemap : die Begriffe kurz erklärt.
- Crawler und Googlebot : wer die Seiten tatsächlich abruft.
Über die Autorin
Lisa-Marie Unger
Lisa-Marie hat 2018 Publizistik und Kommunikationswissenschaften abgeschlossen und arbeitet bei netpulse AG als Projektleiterin für Google Ads. Sie informiert über SEO (Suchmaschinenoptimierung) und führt Schulungen durch.