Lisa-Marie Unger • Aktualisiert am 11. Oktober 2026
Crawl-Tiefe: wichtige Seiten über Links erreichbar machen
Crawl-Tiefe beschreibt, wie viele interne Linkschritte eine Seite von einem gewählten Einstieg entfernt ist. Prüfe damit, ob wichtige Inhalte über echte, nachvollziehbare Links erreichbar sind. Aus einer kurzen Linkdistanz folgt weder automatische Indexierung noch eine bessere Rankingposition.
Betrachte Linkwege, URL-Typen und die tatsächliche Nutzerführung zusammen. Die umfassende Steuerung von robots.txt, Sitemaps und Crawl-Räumen erklärt die bestehende Anleitung Crawling steuern.
Was versteht man unter der Crawl-Tiefe?
Die Crawl-Tiefe bezieht sich auf den Linkweg einer Webseite von einem gewählten Startpunkt, meist der Startseite.
Die Crawl-Tiefe einer Seite wird durch die Anzahl der Links bestimmt, die erforderlich sind, um von der Homepage zu dieser spezifischen Seite zu gelangen. Eine Seite mit direktem Zugriff von der Homepage aus, ohne Zwischenschritte, hat eine geringe Crawl-Tiefe. Eine Seite hat eine grössere Crawl-Tiefe, wenn sie erst nach mehreren internen Linkschritten erreichbar ist.
Der Linkweg ist ein Signal für die Auffindbarkeit. Ein Crawler kann einer erreichbaren Linkfolge folgen, muss aber nicht jede gefundene URL sofort abrufen oder indexieren. Bei einer tief liegenden wichtigen Seite prüfst du deshalb zuerst die tatsächlichen internen Links und den Crawling-/Indexstatus, statt aus der Klickzahl auf ein Rankingproblem zu schliessen.
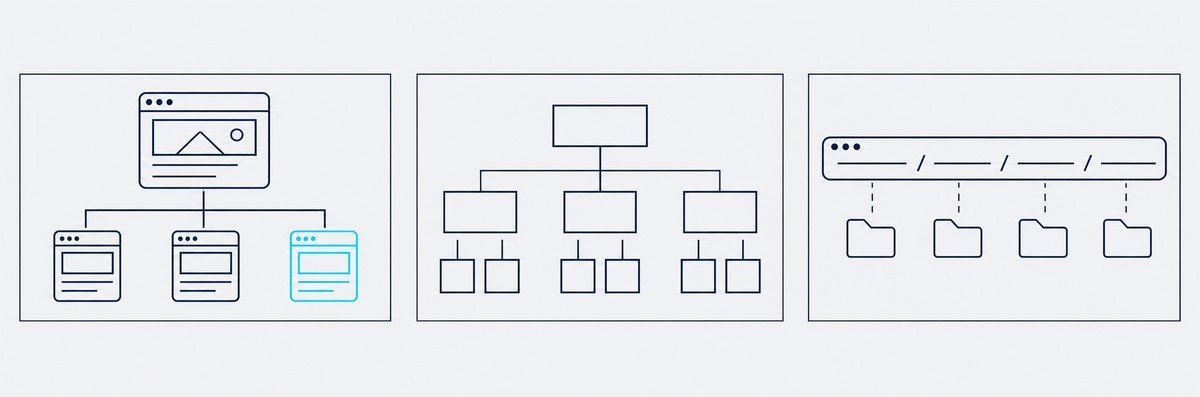
Linkweg ab Startseite
Hierarchie der Inhalte
Ordnertiefe der URL
Linkweg ab Startseite
Hierarchie der Inhalte
Ordnertiefe der URL
Es ist wichtig zu beachten, dass die Crawl-Tiefe nicht mit der Tiefe der Website-Struktur oder der Tiefe einer URL identisch ist. Die Crawl-Tiefe bezieht sich speziell auf den Abstand einer Seite vom Ausgangspunkt in Form von Klicks oder Links, die während des Crawling-Prozesses erforderlich sind.
Im Gegensatz dazu bezieht sich die Tiefe einer Website auf die hierarchische Struktur und Organisation des Inhalts innerhalb einer Website. Die Hierarchie beschreibt Seiten und Abschnitte, die Nutzerinnen und Nutzer in der Navigation durchlaufen. Eine kurze URL oder flache Ordnerstruktur beweist dagegen keinen kurzen Linkweg.
Warum Linkwege wichtig sind und wie du sie prüfst
Wichtige Seiten sollten von passenden Einstiegen und thematisch verwandten Inhalten aus erreichbar sein. Dadurch können Suchmaschinen ihre URLs entdecken. Ob ein Crawler sie tatsächlich abruft, indexiert und ausliefert, musst du getrennt prüfen.
So prüfst du die Linktiefe einer wichtigen URL:
- Wähle den tatsächlichen Einstieg, zum Beispiel die Startseite oder eine passende Bereichsseite.
- Folge den sichtbaren, normalen HTML-Links bis zur Zielseite und notiere den kürzesten sinnvollen Weg.
- Prüfe, ob ein thematisch passender redaktioneller Link den Weg für Nutzer und Crawler verständlicher macht.
- Kontrolliere Linkziel, Statuscode und Canonical der Ziel-URL. Eine Sitemap ergänzt die Entdeckung, ersetzt diese Links aber nicht.
- Vergleiche den beobachteten Crawling- und Indexstatus getrennt mit dem Linkweg. Ladezeit, defekte Links und URL-Varianten sind eigene technische Befunde, nicht die Definition von Crawl-Tiefe.
Fazit
Ein kurzer, hilfreicher Linkweg unterstützt die Entdeckung wichtiger Seiten. Er ersetzt weder die Prüfung von robots.txt und Canonical noch die Entscheidung der Suchmaschine über Indexierung und Ranking. Den übergeordneten Zusammenhang erklärt Technisches SEO.
Über die Autorin
Lisa-Marie Unger
Lisa-Marie hat 2018 Publizistik und Kommunikationswissenschaften abgeschlossen und arbeitet bei netpulse AG als Projektleiterin für Google Ads. Sie informiert über SEO (Suchmaschinenoptimierung) und führt Schulungen durch.