Lisa-Marie Unger • Aktualisiert am 11. Oktober 2026
Interne Suche: Wenn dein Suchfeld zum Risiko wird
Viele Websites haben eine Suchfunktion. Was kaum jemand auf dem Schirm hat: Dieses harmlose Eingabefeld kann sich in ein Einfallstor für Spam verwandeln. Google-Mitarbeiter John Mueller erklärte im Gespräch mit Martin Splitt, warum solche Seiten unter Umständen sogar als gehackt markiert werden können.
Wie aus einem Suchfeld tausende Spam-Seiten werden
Der Mechanismus ist simpel und genau deshalb so verbreitet. Wenn jemand einen Begriff in deine Website-Suche eingibt, entsteht eine Ergebnisseite, die diesen Begriff enthält. Bei den meisten Systemen bekommt diese Seite eine eigene URL, die sich aufrufen und verlinken lässt. Das ist normales Verhalten, kein Fehler.
Genau das nutzen Spammer aus. Angreifer schicken automatisiert Anfragen an dein Suchfeld und erzeugen damit tausende Seiten, die eine Spam-Marke, Keywords und eine Kontaktmöglichkeit enthalten. Anschliessend verlinken sie diese URLs von anderen Websites aus, damit Google sie findet.
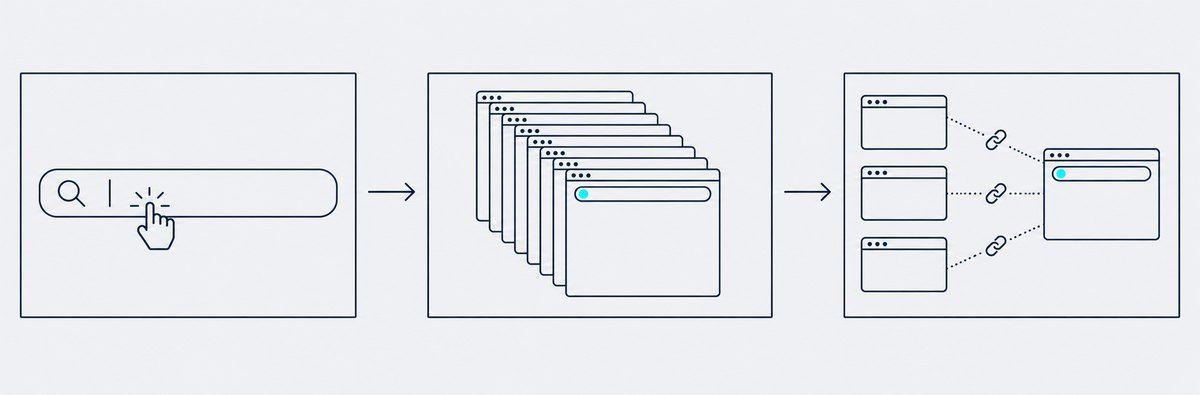
Eingabe im Suchfeld
Eigene URL je Ergebnis
Verlinkung von aussen
Eingabe im Suchfeld
Eigene URL je Ergebnis
Verlinkung von aussen
John Mueller beschreibt das Problem so: Wenn Nutzer nach Dingen suchen können, die überhaupt nichts mit deiner Website zu tun haben, und die Ergebnisseite diese Begriffe anzeigt und indexierbar ist, wird daraus ein Qualitätsproblem. Der entscheidende Punkt in seiner Erklärung: Deine Website muss dafür nicht gehackt worden sein. Das Suchsystem erzeugt diese Seiten, weil es beliebige Suchanfragen annimmt. Genau das macht sie zum Vektor für fremden Spam.
Warum Google solche Seiten als gehackt markieren kann
Der unangenehmste Teil kommt erst. Mueller erklärt, dass Google diese Art von Seiten unter Umständen als gehackt markiert, und zwar auch dann, wenn technisch nichts kompromittiert wurde. In der Search Console kann also plötzlich eine Meldung zu gehackten Inhalten auftauchen, obwohl dein Server sauber ist.
Mueller schildert Fälle im grossen Stil: Angreifer identifizieren gezielt verbreitete CMS-Systeme, deren Suchergebnisseiten nicht blockiert sind, und verlinken dann tausende Websites mit Millionen von Seiten. Der Inhalt folgt einem Muster: ein paar Begriffe aus dem Bereich Pharmazie oder Erotik, dazu eine Telefonnummer oder eine Telegram-Adresse. Das Ziel ist gar nicht, dass jemand deine Website besucht. Es reicht, wenn die Nummer in den Suchergebnissen sichtbar wird.
Für dich bedeutet das: Deine Domain kann zu Anfragen auftauchen, mit denen du nichts zu tun hast, und Suchergebnisse können fremde Suchbegriffe deiner Website zuordnen.
Verlass dich nicht darauf, dass Google es richtet
Mueller weist darauf hin, dass Google solche Seiten algorithmisch erkennen und aus den Suchergebnissen fernhalten kann. Aus Sicht des Website-Betreibers fühlt sich das nach einem gelösten Problem an. Mueller warnt aber ausdrücklich davor, sich darauf zu verlassen.
Das ist eine wichtige Unterscheidung. Dass Google die Seiten nicht mehr anzeigt, heisst nicht, dass sie nicht mehr existieren, nicht mehr gecrawlt werden und keine Ressourcen verbrauchen. Das eigentliche Problem sitzt weiterhin auf deiner Website.
Der unendliche Crawl-Raum
John Mueller erklärt zuerst einen technischen Aspekt, der auch ohne Spammer relevant ist: Manche Suchfelder erzeugen einen praktisch unendlichen Crawl-Raum. Manche Ergebnisseiten verlinken weitere Suchvorschläge wie «Meintest du». Der Crawler folgt diesen Links, landet auf neuen Ergebnisseiten und findet dort wieder Vorschläge.
Mueller formuliert es zugespitzt: Manche freuen sich über die Vorstellung, unendlich viele Seiten bei Google zu haben. Tatsächlich ist das kein Vorteil, sondern ein Problem, weil Google versuchen wird, sie alle zu crawlen. Entstehen sehr viele neue URLs, kann ihre Abruflast für jede betroffene Website zum technischen Problem werden: Suchseiten sind oft nicht zwischengespeichert und können bei jedem Abruf eine Datenbankabfrage auslösen.
Prüfe in deinen Logdaten, ob Such-URLs tatsächlich oft abgerufen werden, wie der Server darauf antwortet und ob wichtige Seiten dadurch später verarbeitet werden. Aus der blossen URL-Zahl folgt noch kein messbarer Umsatzverlust.
So sperrst du das Problem aus
Mueller nennt zwei Wege: robots.txt ist für ihn meist der einfachste, weil Googlebot gesperrte Such-URLs gar nicht abruft. noindex ist für die Anzeige in Suchergebnissen in einer Hinsicht «fast sauberer»: Eine nur per robots.txt gesperrte URL kann ohne Seiteninhalt erscheinen, eine lesbare noindex-Anweisung verhindert das; dafür wird die Seite weiter gecrawlt. Welcher Weg passt, hängt vom Zustand der konkreten Such-URLs ab.
Eine mögliche Massnahme ist eine passende robots.txt-Regel. Kooperierende Crawler wie Googlebot rufen gesperrte Such-URLs dann nicht ab. Eine solche Sperre verhindert weder missbräuchliche Anfragen an dein Suchfeld noch zuverlässig die Anzeige einer bekannten URL ohne Inhalt in Suchergebnissen. Prüfe vor der Regel ihren Geltungsbereich und ob bereits indexierte URLs zuerst eine lesbare noindex-Anweisung brauchen. Die technische Prüfung hat vier Teile:
- Welche Such-URLs erzeugt das System und welche sollen überhaupt abrufbar bleiben?
- Welche URL-Muster lassen sich für kooperierende Crawler abgrenzen, ohne wichtige Seiten mitzusperren?
- Sind Such-URLs bereits indexiert und brauchen sie vor einer Crawlsperre eine lesbare noindex-Anweisung?
- Begrenzen separate Schutzmassnahmen auch Spam-Anfragen an das Suchfeld?
Mueller empfiehlt möglichst eine klare Regel für das ganze Such-URL-Muster. Prüfe dafür die tatsächlich erzeugten Parameter, Pfade und Filterkombinationen. Eine zu enge Regel verfehlt Varianten; eine zu breite könnte nützliche Kategorie- oder Tag-Seiten mit eigenem Zweck treffen. Wie du Crawl-Regeln und URL-Räume gegeneinander prüfst, zeigt die Anleitung Crawling steuern.
noindex löst eine andere Aufgabe. Die Anweisung verhindert bei unterstützenden Suchmaschinen, dass eine abrufbare Suchergebnisseite in den Suchergebnissen erscheint. Dafür muss der Crawler die Anweisung lesen können; blockierst du dieselbe URL in robots.txt, kann noindex ungelesen bleiben. Soll ein grosser URL-Raum nicht gecrawlt werden, prüfe eine passende robots.txt-Regel. Soll eine bereits indexierte URL aus den Google-Ergebnissen entfernt werden, prüfe noindex auf einer abrufbaren Seite und kontrolliere die Wirkung nach dem nächsten Crawl. Zugangsschutz und Massnahmen gegen missbräuchliche Anfragen sind davon getrennt.
Interne Suchergebnisseiten haben oft keinen eigenständigen Nutzen für die Google-Suche. Ob eine konkrete URL aufgenommen wurde und ob sie für Nutzer eine Aufgabe erfüllt, prüfst du im eigenen Bestand. Eine Crawlsperre allein ist keine Zusage, dass ihre Adresse aus Suchergebnissen verschwindet.
Dein Praxis-Check in fünf Minuten
Prüfe drei Dinge auf deiner Website:
Such-URLs prüfen
Ermittle im eigenen System beispielhafte Suchparameter wie ?s= oder ?q= und prüfe einzelne vollständige URLs im URL-Prüftool der Search Console. Eine site:-Suche kann Hinweise liefern, ist aber kein vollständiger Indexierungsnachweis.
Robots.txt
Öffne deine Datei unter der Adresse /robots.txt und schau nach, ob dort eine Regel für den Suchpfad steht.
Search Console
Wirf einen Blick in den Bereich Sicherheitsprobleme und in den Indexierungsbericht. Auffällig viele fremde URLs sind ein Warnsignal.
Wenn du unsicher bist, welchen Parameter deine Website nutzt, führe einfach selbst eine Suche durch und schau in die Adresszeile. Der Teil nach dem Fragezeichen ist die Antwort.
Du möchtest verhindern, dass deine interne Suche zum Einfallstor für Spam wird?
netpulse prüft deine Suchfunktion, Indexierung und robots.txt auf mögliche Risiken. Melde dich, um unnötige Such-URLs und mögliche Spam-Zugriffe getrennt prüfen zu lassen.
Was das für dich bedeutet
Manche Plattformen begrenzen die Sichtbarkeit interner Suchergebnisseiten bereits. Verlass dich darauf nicht ohne Messung: Prüfe an deinem System die tatsächlich erzeugten URLs, Crawling-Regeln, Indexierungsanweisungen und die Wirkung auf bestehende Such-URLs.
Auch bei älteren Installationen, selbst entwickelten Suchfunktionen und CMS-Standardeinstellungen lohnt sich deshalb die konkrete Prüfung. Eine verlinkbare Ergebnisseite mit frei wählbarem Suchtext kann missbraucht werden, unabhängig vom Alter der Plattform.
Eine robots.txt-Regel kann den Abruf passender URL-Muster begrenzen. Ob das genügt, hängt von Suchparametern, bereits indexierten URLs und dem Schutz vor automatisierten Spam-Anfragen ab. Prüfe die drei Ebenen getrennt, bevor du die Änderung veröffentlichst.
Quellen
- Google Search Off the Record, Folge 113: Originaltranskript als PDF, Gespräch mit John Mueller und Martin Splitt. Relevante Stellen: unendlicher URL-Raum ab 04:16, robots.txt und noindex ab 08:15 und 13:18, keine allgemeine Pflicht zum Blockieren ab 17:43, mögliche Qualitätsprobleme bei fremden Suchbegriffen ab 20:41, tausende Sites/Millionen Seiten und mögliche «hacked»-Kennzeichnung ab 23:26.
- Google: robots.txt regelt Crawling, nicht zuverlässig die Anzeige einer URL.
- Google: noindex auf abrufbaren URLs und Wirkung nach erneutem Crawl.
Mehr dazu: Technisches SEO
Über die Autorin
Lisa-Marie Unger
Lisa-Marie hat 2018 Publizistik und Kommunikationswissenschaften abgeschlossen und arbeitet bei netpulse AG als Projektleiterin für Google Ads. Sie informiert über SEO (Suchmaschinenoptimierung) und führt Schulungen durch.