Indexierung steuern: noindex, Canonical und Search Console
Ob eine Seite im Suchindex erscheint, entscheidet kein einzelner Schalter. noindex, Canonical, interne Links und die XML-Sitemap beantworten verschiedene Fragen. Erst ihr Zusammenspiel ergibt das Bild, das später in der Search Console sichtbar wird.
Ziel dieser Anleitung: Du kannst danach für eine wichtige URL feststellen, ob sie indexiert ist, welchen Grund ein Ausschluss trägt und welche einzelne Massnahme als Nächstes sinnvoll ist. Indexierung steuern ist ein Baustein des technischen SEO.
Indexierung steuern statt Signale vermischen
Eine Suchmaschine ruft eine URL zuerst ab und entscheidet danach getrennt, ob die Seite in den Index aufgenommen wird. Crawling und Indexierung sind zwei verschiedene Fragen, und die Antwort auf die eine ersetzt die andere nicht. Wer beide Ebenen vermischt, sperrt eine Seite versehentlich vom Abruf aus und wundert sich dann, warum die noindex-Anweisung nie gelesen wurde.
Diese Anleitung führt durch eine nachvollziehbare Prüfung: wichtige URL bestimmen, Indexstatus und gewählte kanonische Adresse getrennt lesen, die Signale einzeln beurteilen und erst danach eine einzelne Änderung planen. Der Rahmen dazu steht im technischen SEO.
Die wichtige URL zuerst prüfen
Beginne nicht mit einer Liste aller Auffälligkeiten, sondern mit einer Adresse, die zählt. Nimm die vollständige URL mit Protokoll und Host, und wähle in der Search Console die Property, die genau zu dieser Adresse passt. Eine Property für die falsche Variante zeigt Daten, die zur geprüften Seite gar nicht gehören.
Die URL-Prüfung beantwortet drei Dinge getrennt: ob die Adresse im Index ist, welchen Grund ein Ausschluss trägt und welche URL Google als kanonisch gewählt hat. Lies diese drei Angaben einzeln, statt sie zu einem Gesamturteil zu verrühren. Was Indexierung grundsätzlich bedeutet, erklärt der Glossareintrag Indexierung im Glossar.
Gespeicherter Indexstand und Live-Test sind zwei Auskünfte
Die Angaben aus der URL-Prüfung stammen aus dem zuletzt gespeicherten Stand. Der Live-Test daneben ruft die Adresse in diesem Moment erneut ab und zeigt, ob sie gerade erreichbar ist und welche Anweisungen sie heute ausliefert. Beides kann auseinanderfallen: Eine Seite, die seit der letzten Verarbeitung korrigiert wurde, zeigt im gespeicherten Stand noch den alten Befund.
Lies den Live-Test darum als Auskunft über den heutigen Abruf, nicht als Ergebnis. Ein erfolgreicher Live-Test belegt weder die Aufnahme in den Index noch eine bestimmte kanonische Auswahl; er belegt, dass die Adresse abrufbar ist und welche Signale sie dabei mitgibt. Die Entscheidung über Index und kanonische Adresse fällt erst bei der nächsten Verarbeitung.
Stimmt die geprüfte Adresse?
Prüfe Protokoll, Host, Sprachpfad und abschliessenden Schrägstrich. Eine Variante mit oder ohne www ist technisch eine andere URL. Erst wenn die geprüfte Adresse die gemeinte ist, sagt der Befund etwas über die Seite aus.
Was meldet der Indexstatus?
Der Status trennt zwischen aufgenommen und nicht aufgenommen und nennt im zweiten Fall einen Grund. Ein Ausschluss kann gewollt sein. Notiere den Grund wörtlich, statt ihn sinngemäss umzudeuten.
Welche Adresse gilt als kanonisch?
Die von Google gewählte kanonische URL kann von der selbst angegebenen abweichen. Diese Abweichung ist ein Befund für sich und wird getrennt vom Indexstatus festgehalten.
noindex gezielt einsetzen
Die Anweisung noindex hält eine abrufbare Seite aus dem Index. Sinnvoll ist das bei Inhalten, die für Suchende keinen eigenen Zweck haben: Dankeseiten nach einem Formular, interne Suchergebnisse, technische Varianten oder Testseiten. Was der Begriff genau bezeichnet, steht unter noindex im Glossar.
Damit die Anweisung wirkt, muss eine Suchmaschine sie lesen können, und dafür muss sie die URL abrufen dürfen. Ein möglicher Fehler entsteht genau an dieser Stelle: Ein Pfad wird zugleich in der robots.txt gesperrt und mit noindex versehen. Die Sperre verhindert den Abruf, die Anweisung bleibt ungelesen, und die Adresse kann über andere Wege trotzdem bekannt werden. Die beiden Werkzeuge robots.txt richtig abgrenzen heisst deshalb: Die robots.txt regelt den Abruf, noindex regelt die Aufnahme in den Index.
Wichtige Seiten nicht versehentlich ausschliessen
Ein noindex auf einer Vorlage, einem Seitentyp oder einer ganzen Sprachversion trifft schnell mehr Seiten als gedacht. Prüfe deshalb vor jeder Änderung, welche Adressen die Regel tatsächlich erfasst, und kontrolliere nach der Änderung mindestens eine betroffene Seite einzeln.
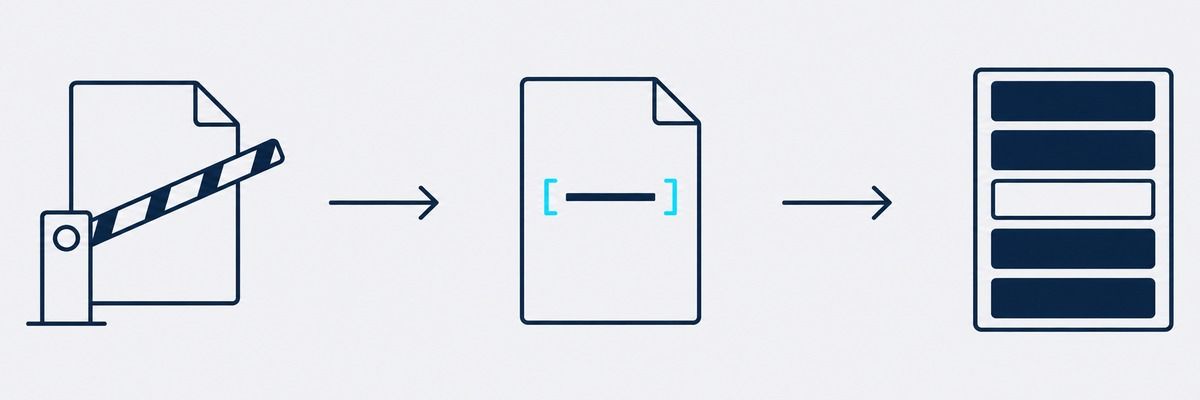
Seite abrufbar
noindex wird gelesen
Nicht indexieren
Canonical bei ähnlichen URLs prüfen
Der Eintrag Canonical-Tag im Glossar beschreibt, wie die bevorzugte Version unter mehreren ähnlichen Adressen benannt wird. Es ist ein Hinweis, keine Anweisung: Google fasst ähnliche URLs zu einem Cluster zusammen und wählt daraus selbst eine kanonische Adresse. Weicht diese Wahl von der eigenen Angabe ab, ist ein Widerspruch zwischen den übrigen Signalen eine der zu prüfenden Möglichkeiten.
Prüfe deshalb im Zusammenhang, ob Canonical, interne Links, Sitemap-Eintrag und Weiterleitungen dieselbe Adresse meinen. Nach einer Korrektur folgt zuerst ein erneuter Abruf, dann eine dokumentierte Beobachtung. Wiederhole die Prüfung nicht hektisch: Halte Datum, geänderte Stelle und beobachteten Stand fest und beurteile beim nächsten Termin.
Den Indexierungsbericht priorisieren
Der Indexierungsbericht der Search Console trennt indexierte von nicht indexierten Seiten und ordnet die zweite Gruppe nach Gründen. Diese Liste ist keine Mängelliste, die von oben nach unten abgearbeitet wird. Sortiere stattdessen danach, wie viele deiner wichtigen Zielseiten ein Grund betrifft. Trägt ein grosser Posten ausschliesslich technische Varianten, die gar nicht in den Index gehören, ist er weniger dringend als ein einzelner Ausschluss auf einer Angebotsseite, die dort hingehört. Welcher Fall vorliegt, entscheidet die Absicht hinter der betroffenen Adresse, nicht die Zahl daneben. Den Begriff selbst erklärt der Eintrag Indexierung im Glossar.
Gruppe zuerst, Einzelfall danach
Der Bericht zeigt Muster über viele Adressen. Für die Einzelprüfung einer konkreten Seite ist die URL-Prüfung das passende Werkzeug. Beide ergänzen sich: Das Muster zeigt, wo es lohnt, die Einzelprüfung zeigt, was an dieser einen Adresse los ist.
Indexierung ist kein Ranking
Eine indexierte Seite kann zu einer Suchanfrage ausgespielt werden, ist damit aber weder tatsächlich ausgespielt noch gut platziert. Aufnahme in den Index ist eine Voraussetzung. Position und Klicks hängen zusätzlich von Inhalt, Suchintention und Wettbewerb ab.
Varianten, Sitemap und interne Links zusammen prüfen
Viele Indexierungsbefunde entstehen nicht an einer einzelnen Seite, sondern an einer Gruppe technisch erzeugter Adressen. Filter, Sortierungen, Parameter und paginierte Seiten sehen sich ähnlich, haben aber unterschiedliche Aufgaben. Beurteile jede Gruppe einzeln: Welche dieser Adressen soll überhaupt indexiert werden, welche ist nur ein Weg zu anderen Inhalten, und welche hat für Suchende keinen eigenen Zweck?
Halte danach Sitemap, Canonical und interne Links nebeneinander. In die XML-Sitemap gehören die kanonischen, indexierbaren Zielseiten. Interne Links sollten dieselben Adressen meinen. Paginierte Seiten sind dabei ein eigener Fall mit eigenen Regeln; wie sich das sauber lösen lässt, zeigt die Anleitung Pagination richtig prüfen.
Sitemap, URL-Varianten und interne Links werden nicht einzeln beurteilt, sondern gemeinsam: Erst im Abgleich zeigt sich, ob alle dieselbe Adresse meinen.
Prüfablauf vor jeder technischen Änderung
Eine Indexierungsänderung wirkt selten sofort und lässt sich ohne Aufnahme des Vorzustands kaum beurteilen. Diese fünf Schritte halten die Arbeit nachvollziehbar und den Rückweg offen: Ist-Zustand erfassen, Ziel und Umfang festlegen, Backup und Rückweg anlegen, Erst nach dem Backup ausführen, Beobachten und erneut prüfen.
Ist-Zustand erfassen
Dokumentiere die betroffenen URLs, die sichtbare Navigation, die tatsächlichen Linkziele, die Canonical-Werte sowie Filter- und Sortiervarianten.
Ziel und Umfang festlegen
Beschreibe das Nutzerproblem oder den technischen Befund und halte fest, welche URLs, Links, Canonical-Angaben, Filter oder Sortierungen betroffen sind.
Backup und Rückweg anlegen
Erstelle vor jeder Ausführung oder Mutation einen Sicherungspunkt und halte den Rückweg fest.
Erst nach dem Backup ausführen
Setze nur die zuvor dokumentierte Änderung um und prüfe danach die Erreichbarkeit, die Nutzerführung und die betroffenen technischen Signale.
Beobachten und erneut prüfen
Werte die konkrete Ausgangslage nach der Änderung aus und prüfe bei neuen Filtern, Sortierungen oder Navigationsmustern erneut.
Unklar, warum eine wichtige Seite fehlt?
netpulse nimmt deine wichtigen URLs, den Indexstatus und die kanonischen Signale auf und zeigt dir, welcher einzelne Schritt zuerst sinnvoll ist.
Häufige Fragen
noindex oder robots.txt, was ist wann richtig?
Die robots.txt regelt, ob eine URL abgerufen wird. Der Eintrag noindex im Glossar beschreibt die andere Frage: ob eine abrufbare URL in den Index kommt. Beides gleichzeitig auf denselben Pfad zu setzen, verhindert in der Regel, dass die noindex-Anweisung überhaupt gelesen wird.
Canonical oder Weiterleitung?
Ein Canonical passt, wenn mehrere ähnliche Adressen bestehen bleiben sollen und eine davon die bevorzugte ist. Eine Weiterleitung passt, wenn eine Adresse dauerhaft durch eine andere ersetzt wird: Der Aufruf der alten Adresse führt dann zum neuen Ziel. Die Entscheidung folgt der Absicht, nicht dem Aufwand.
Wie lese ich den Indexierungsbericht richtig?
Der Bericht trennt indexierte von nicht indexierten Seiten und gruppiert die zweite Menge nach Gründen. Er zeigt Muster über viele Adressen, nicht das Urteil über eine einzelne. Nimm einen Grund, prüfe, welche deiner wichtigen Zielseiten er betrifft, und geh für diese eine Adresse in die URL-Prüfung. Die Zahl neben einem Grund ist eine Menge, keine Dringlichkeit.
Wie gehe ich mit paginierten Seiten um?
In der Regel erhält eine paginierte Seite eine self-referencing Canonical-URL, also einen Verweis auf sich selbst, sofern die Seite eigene Inhalte zeigt. Prüfe dafür je URL die sichtbare Ergebnis- oder Inhaltsmenge, die Canonical-Angabe und die echte Navigation. Beurteile Canonical, noindex, Sitemap und interne Links als unterschiedliche Signale und ändere sie nicht pauschal.
Wie schnell wirkt eine Änderung an der Indexierung?
Das ist offen und hängt von der Website, der Änderung und dem erneuten Abruf ab. Verlässlich ist nur das Vorgehen: Vorzustand festhalten, eine Änderung vornehmen, Termin für die Kontrolle setzen und beim Termin dieselbe Adresse erneut prüfen.
Bedeutet indexiert auch sichtbar auf Seite eins?
Nein. Die Aufnahme in den Index ist die Voraussetzung dafür, überhaupt gefunden zu werden. Welche Position eine Seite erreicht, entscheidet sich zusätzlich über Inhalt, Suchintention und Wettbewerb.
Weiterlesen zu Indexierung und Kanonisierung
Die folgenden Themen schliessen fachlich an diese Seite an:
- Technisches SEO : die Übersichtsseite, unter der diese Anleitung steht.
- Indexierung im Glossar : was die Aufnahme in den Suchindex bedeutet.
- Canonical-Tag im Glossar : wie die bevorzugte Version unter ähnlichen Adressen benannt wird.
Autorin: Lisa-Marie Unger
Über die Autorin
Lisa-Marie Unger
Lisa-Marie hat 2018 Publizistik und Kommunikationswissenschaften abgeschlossen und arbeitet bei netpulse AG als Projektleiterin für Google Ads. Sie informiert über SEO (Suchmaschinenoptimierung) und führt Schulungen durch.